Firexport가이드
Firestore 데이터를 CSV로 내보내는 방법
Firebase 콘솔은 Firestore 데이터를 보여 주지만 CSV로 내려받는 버튼은 없습니다. Firestore에서 CSV 파일을 뽑아내는 실용적인 방법은 세 가지입니다. 어느 것이 맞는지는 데이터 양과 감수할 준비 작업의 양에 달려 있습니다.
2026년 9월 24일 업데이트. 방법 1의 확장 프로그램 Firexport는 저희가 만든 것입니다. 방법 2와 3에는 필요 없습니다.
짧은 답
| 1. 콘솔 + 확장 프로그램 | 2. Admin SDK 스크립트 | 3. gcloud + BigQuery | |
|---|---|---|---|
| 준비 | Chrome 확장 프로그램 설치 | Node.js와 Google Cloud 사용자 인증 정보 | Cloud Storage 버킷과 BigQuery 데이터 세트 |
| 결제 계정 | 필요 없음 | 필요 없음 | 필요(Blaze 요금제) |
| 내보내는 범위 | 쿼리 빌더 쿼리 하나(필터·정렬·제한 포함) | 코드가 쿼리하는 것 전부 | 컬렉션 전체 |
| 타임스탬프 | 콘솔에 표시되는 대로(Advanced는 ISO 8601) | ISO 8601 | BigQuery TIMESTAMP |
| 맵과 배열 | 콘솔의 텍스트. 긴 값은 “…”로 잘릴 수 있음(Advanced는 전체) | 한 셀에 JSON | 평탄화 쿼리 후 한 셀에 JSON |
1. Firexport로 Firebase 콘솔에서 내보내기
Firebase 콘솔의 Firestore 페이지에는 쿼리를 실행해 결과를 표로 보여 주는 쿼리 빌더(Query builder)가 있지만, 그 결과를 내려받을 방법은 없습니다. Firexport는 그 결과 옆에 내보내기 버튼을 추가하는 무료 Chrome 확장 프로그램입니다.
- Chrome 웹 스토어에서 Firexport를 설치합니다.
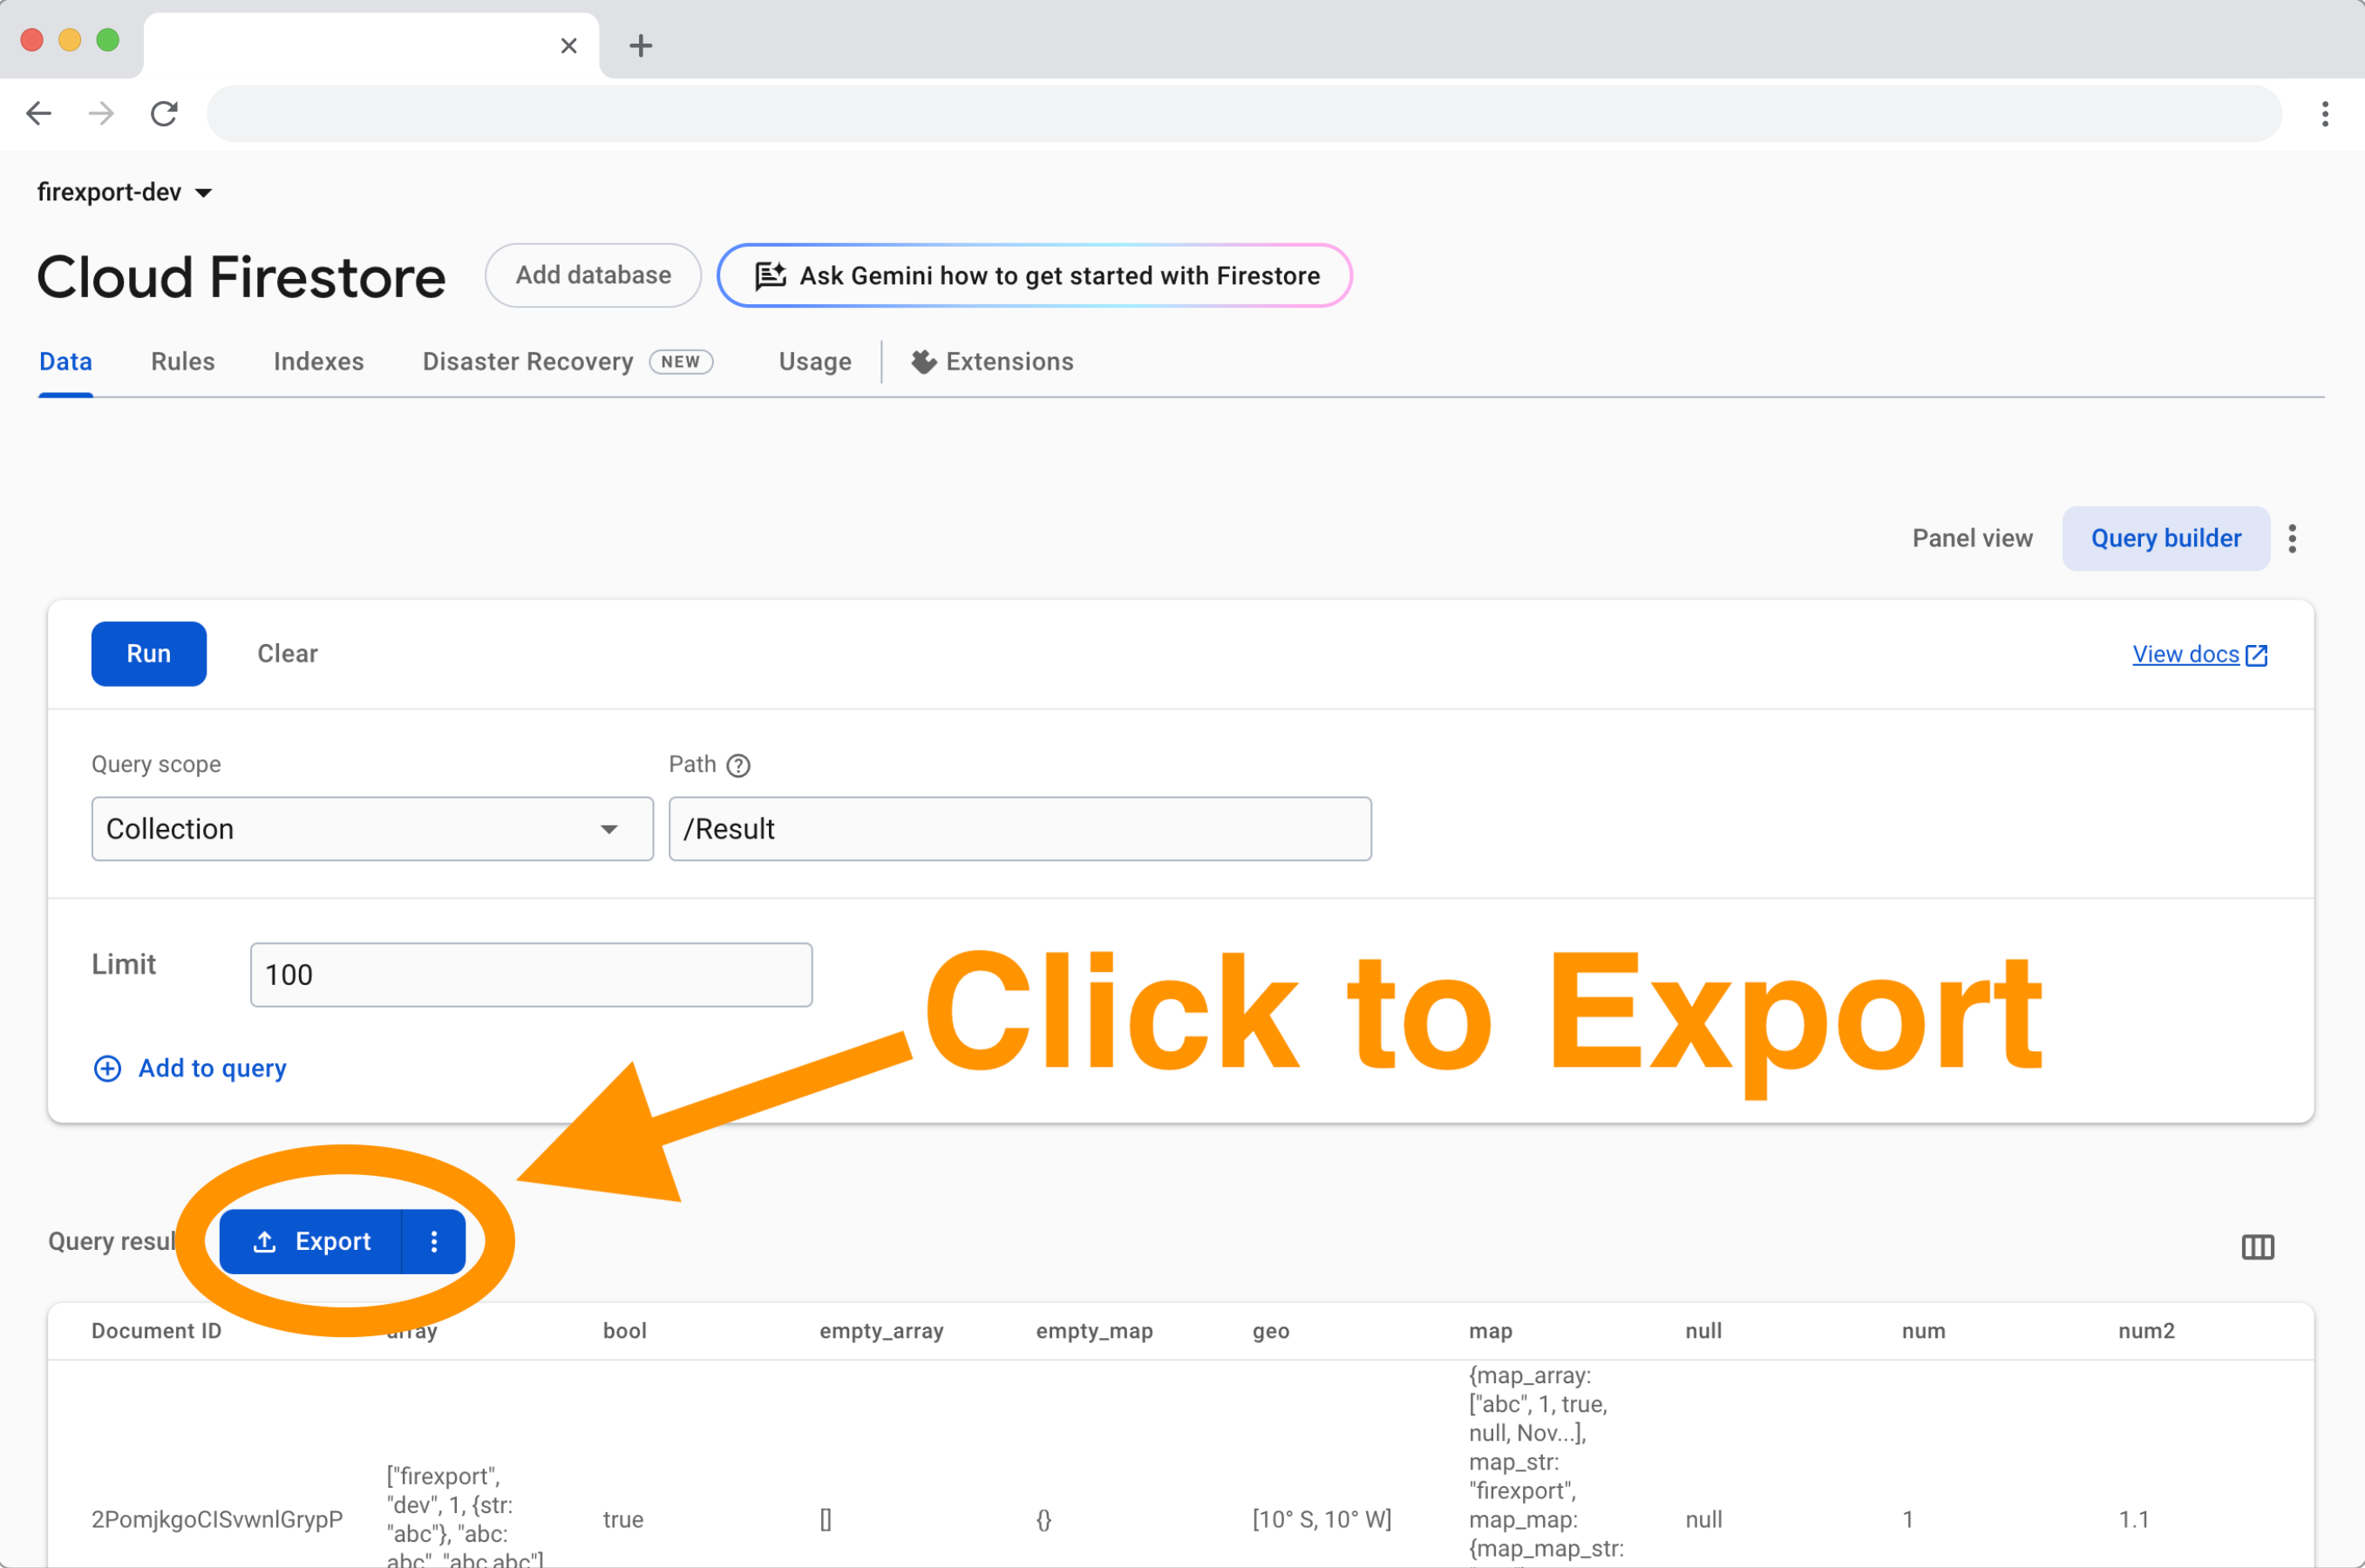
- Firebase 콘솔에서 Firestore Database를 열고 패널 뷰(Panel view)에서 쿼리 빌더(Query builder)로 전환합니다(데이터 탭의 오른쪽 위).
- 쿼리 범위(Query scope)와 경로(Path)에서 컬렉션을 고르고, 필요하면 필터나 제한을 더한 뒤 실행(Run)을 클릭합니다.
- 결과 위의 내보내기를 클릭합니다. Firexport가 결과의 모든 페이지를 훑어 CSV 파일 하나를 내려받습니다. JSON이 필요하면 버튼 옆의 ⋮ 메뉴를 열어 JSON 내보내기를 고릅니다.
파일에 들어가는 것:
- 문서 ID(Document ID) 열, 그다음 콘솔 표에 보이는 순서대로 필드마다 열 하나.
- 값은 콘솔에 표시되는 그대로입니다. 무료 버전에서는 타임스탬프가 콘솔의 표시 형식(브라우저의 언어와 시간대)이고, 참조는 줄인 형태이며, 긴 맵이나 배열은 “…”로 잘릴 수 있습니다.
- 1회 구매 라이선스인 Firexport Advanced는 콘솔이 이미 불러온 데이터에서 ISO 8601 타임스탬프, 전체 참조 경로, 지오포인트, 잘리지 않은 맵과 배열을 복원합니다.
서비스 계정 키도, 결제 설정도 필요 없습니다. 이미 로그인한 콘솔 세션에서 동작하고 파일은 브라우저 안에서 만들어집니다. 한 번에 쿼리 하나를 내보내므로, 하위 컬렉션은 컬렉션 그룹으로 쿼리할 때만 함께 나옵니다. Chrome과 다른 Chromium 기반 브라우저에서 동작합니다.
스크립트도 서비스 계정 키도 없이, 다음 Firestore 쿼리를 콘솔에서 바로 내보내 보세요.
 Chrome에 추가 — 무료
2. Admin SDK 스크립트로 내보내기
확장 프로그램을 쓰고 싶지 않거나 내보내기를 일정에 따라 돌려야 한다면, Firebase Admin SDK를 쓰는 짧은 Node.js 스크립트면 됩니다. Firestore를 읽을 수 있는 계정이 필요합니다. 프로젝트 소유자나 편집자, 또는 Cloud Datastore 뷰어 역할입니다.
- SDK 설치:
npm install firebase-admin - 로컬 사용자 인증 정보로 로그인:
gcloud auth application-default login. 서버에서는 대신GOOGLE_APPLICATION_CREDENTIALS가 서비스 계정 키를 가리키게 합니다. - 아래 스크립트를
export-to-csv.mjs로 저장하고your-project-id를 바꾼 뒤node export-to-csv.mjs users를 실행합니다.
// Usage: node export-to-csv.mjs users   → writes users.csv
import { writeFileSync } from 'node:fs';
import { initializeApp } from 'firebase-admin/app';
import {
  getFirestore,
  FieldPath,
  Timestamp,
  GeoPoint,
  DocumentReference,
} from 'firebase-admin/firestore';

initializeApp({ projectId: 'your-project-id' });
const db = getFirestore();
const collection = process.argv[2];
if (!collection) throw new Error('Usage: node export-to-csv.mjs <collection>');

// Read the collection 1,000 documents at a time, so large collections don't time out.
const docs = [];
let last;
while (true) {
  let query = db.collection(collection).orderBy(FieldPath.documentId()).limit(1000);
  if (last) query = query.startAfter(last);
  const page = await query.get();
  if (page.empty) break;
  docs.push(...page.docs);
  last = page.docs[page.docs.length - 1];
}

// Firestore types become plain values: timestamps as ISO 8601, references as paths.
function plain(value) {
  if (value instanceof Timestamp) return value.toDate().toISOString();
  if (value instanceof DocumentReference) return value.path;
  if (value instanceof GeoPoint) return { latitude: value.latitude, longitude: value.longitude };
  if (value instanceof Uint8Array) return Buffer.from(value).toString('base64');
  if (Array.isArray(value)) return value.map(plain);
  if (value && typeof value === 'object') {
    return Object.fromEntries(Object.entries(value).map(([key, v]) => [key, plain(v)]));
  }
  return value;
}

// Maps and arrays go in one cell as JSON. Quote any cell with a comma, a quote or a line break.
function cell(value) {
  if (value === null || value === undefined) return '';
  const text = typeof value === 'object' ? JSON.stringify(value) : String(value);
  return /[",\r\n]/.test(text) ? `"${text.replaceAll('"', '""')}"` : text;
}

const rows = docs.map((doc) => ({ documentId: doc.id, ...plain(doc.data()) }));
// Documents in one collection can have different fields, so the columns are all of them.
const columns = [...new Set(rows.flatMap((row) => Object.keys(row)))];
const lines = [columns, ...rows.map((row) => columns.map((column) => row[column]))];
writeFileSync(`${collection}.csv`, lines.map((line) => line.map(cell).join(',')).join('\r\n'));
console.log(`Wrote ${rows.length} documents to ${collection}.csv`);- 모든 상위 문서에 걸친 하위 컬렉션을 내보내려면
db.collection을db.collectionGroup으로 바꿉니다. - 이 스크립트는 파일을 쓰기 전에 모든 행을 메모리에 담습니다. 문서가 수백만 건이면 방법 3을 쓰세요.
3. gcloud와 BigQuery로 내보내기
Firestore의 관리형 내보내기는 CSV가 아니라 Firestore 고유 형식의 백업을 Cloud Storage에 씁니다. BigQuery가 그 형식을 불러와 CSV로 쓸 수 있습니다. 큰 컬렉션에 맞는 길이지만, 결제 계정(Blaze 요금제)과 내보내기를 실행하고 버킷에 쓸 권한이 필요합니다. 필요한 역할은 Google의 내보내기 및 가져오기 문서에 있습니다.
# 1. Export one collection. BigQuery only loads exports made with --collection-ids.
gcloud firestore export gs://YOUR_BUCKET/users-export --collection-ids=users

# 2. Load it into a BigQuery dataset in the same location as the bucket.
bq --location=US mk --dataset firestore_export
bq load --source_format=DATASTORE_BACKUP firestore_export.users \
  gs://YOUR_BUCKET/users-export/all_namespaces/kind_users/all_namespaces_kind_users.export_metadata
BigQuery는 중첩 열을 CSV로 쓸 수 없는데, Firestore 내보내기에서 불러온 표에는 늘 하나가 있습니다. 문서 ID를 담은 __key__입니다. 그래서 먼저 쿼리로 맵과 배열을 JSON 텍스트로 바꾼 평탄한 복사본을 만들고 그것을 추출합니다.
# 3. Make a flat copy: maps and arrays become JSON text. List your own fields.
bq query --use_legacy_sql=false --destination_table=firestore_export.users_flat \
'SELECT __key__.name AS documentId, email, createdAt,
        TO_JSON_STRING(address) AS address, TO_JSON_STRING(tags) AS tags
 FROM firestore_export.users'

# 4. Write it to CSV and download it.
bq extract --destination_format=CSV firestore_export.users_flat gs://YOUR_BUCKET/users.csv
gcloud storage cp gs://YOUR_BUCKET/users.csv .- BigQuery는 파일 하나에 최대 1GB를 씁니다. 더 크면
gs://YOUR_BUCKET/users-*.csv처럼 와일드카드를 씁니다. - 내보내기는 문서마다 문서 읽기 1회로 과금됩니다. 끝나면 Cloud Storage 용량을 계속 쓰지 않도록 내보내기 폴더를 삭제하세요.
FAQ
Firebase 콘솔에서 Firestore 데이터를 CSV로 내보낼 수 있나요?
아니요. Firebase 콘솔의 Firestore 페이지에는 다운로드 버튼이 없습니다. 관리형 내보내기(Google Cloud 콘솔의 가져오기/내보내기 페이지 또는 gcloud firestore export)는 Firestore 고유 형식의 백업을 Cloud Storage에 씁니다. 데이터 복원용이지 스프레드시트에서 열기 위한 것이 아닙니다.
Firestore 데이터를 내보내면 비용이 드나요?
어떤 방법이든 내보내는 문서마다 최소 한 번은 읽고, Firestore는 그것을 문서 읽기로 과금합니다. 일일 무료 할당량 안에서는 비용이 없습니다. 관리형 내보내기는 추가로 프로젝트에 결제 계정이 연결돼 있어야 하고, 그 파일은 삭제하기 전까지 Cloud Storage 용량을 차지합니다.
하위 컬렉션은 어떻게 내보내나요?
컬렉션 그룹으로 쿼리합니다. 콘솔에서는 쿼리 빌더의 쿼리 범위(Query scope)를 컬렉션 그룹(Collection group)으로 고릅니다. 스크립트에서는 db.collection() 대신 db.collectionGroup()을 씁니다. gcloud에서는 하위 컬렉션의 ID를 --collection-ids에 넘깁니다.
대신 JSON으로 내보낼 수 있나요?
네. Firexport의 내보내기 메뉴에 JSON 내보내기가 있습니다. 스크립트는 CSV 대신 JSON.stringify(rows)를 쓰면 됩니다. BigQuery에서는 bq extract --destination_format=NEWLINE_DELIMITED_JSON이 맵과 배열을 중첩된 채로 유지합니다.