如何将 Firestore 数据导出为 CSV
Firebase 控制台可以显示 Firestore 数据,却没有把它下载为 CSV 的按钮。要从 Firestore 得到 CSV 文件,有三种实用的方法。哪一种合适,取决于数据量和你愿意做多少准备工作。
更新于 2026年9月24日。 方法 1 中的扩展程序 Firexport 是我们开发的。方法 2 和 3 不需要它。
简短回答
| 1. 控制台 + 扩展程序 | 2. Admin SDK 脚本 | 3. gcloud + BigQuery | |
|---|---|---|---|
| 准备工作 | 安装一个 Chrome 扩展程序 | Node.js 和 Google Cloud 凭据 | Cloud Storage 存储桶和 BigQuery 数据集 |
| 需要启用结算 | 不需要 | 不需要 | 需要(Blaze 方案) |
| 导出范围 | 查询构建器中的一个查询,含其过滤、排序和限制 | 代码查询到的任何内容 | 整个集合 |
| 时间戳 | 按控制台显示的样子(Advanced 为 ISO 8601) | ISO 8601 | BigQuery TIMESTAMP |
| 映射和数组 | 控制台中的文本。较长的值可能被“…”截断(Advanced 为完整值) | 一个单元格内的 JSON | 经扁平化查询后,一个单元格内的 JSON |
1. 用 Firexport 从 Firebase 控制台导出
Firebase 控制台的 Firestore 页面有一个查询构建器(Query builder),可以运行查询并把结果显示在 表格中,但没有任何下载它们的办法。Firexport 是一款免费的 Chrome 扩展程序,会在这些结果旁边添加一个“导出”按钮。
- 从 Chrome 应用商店安装 Firexport。
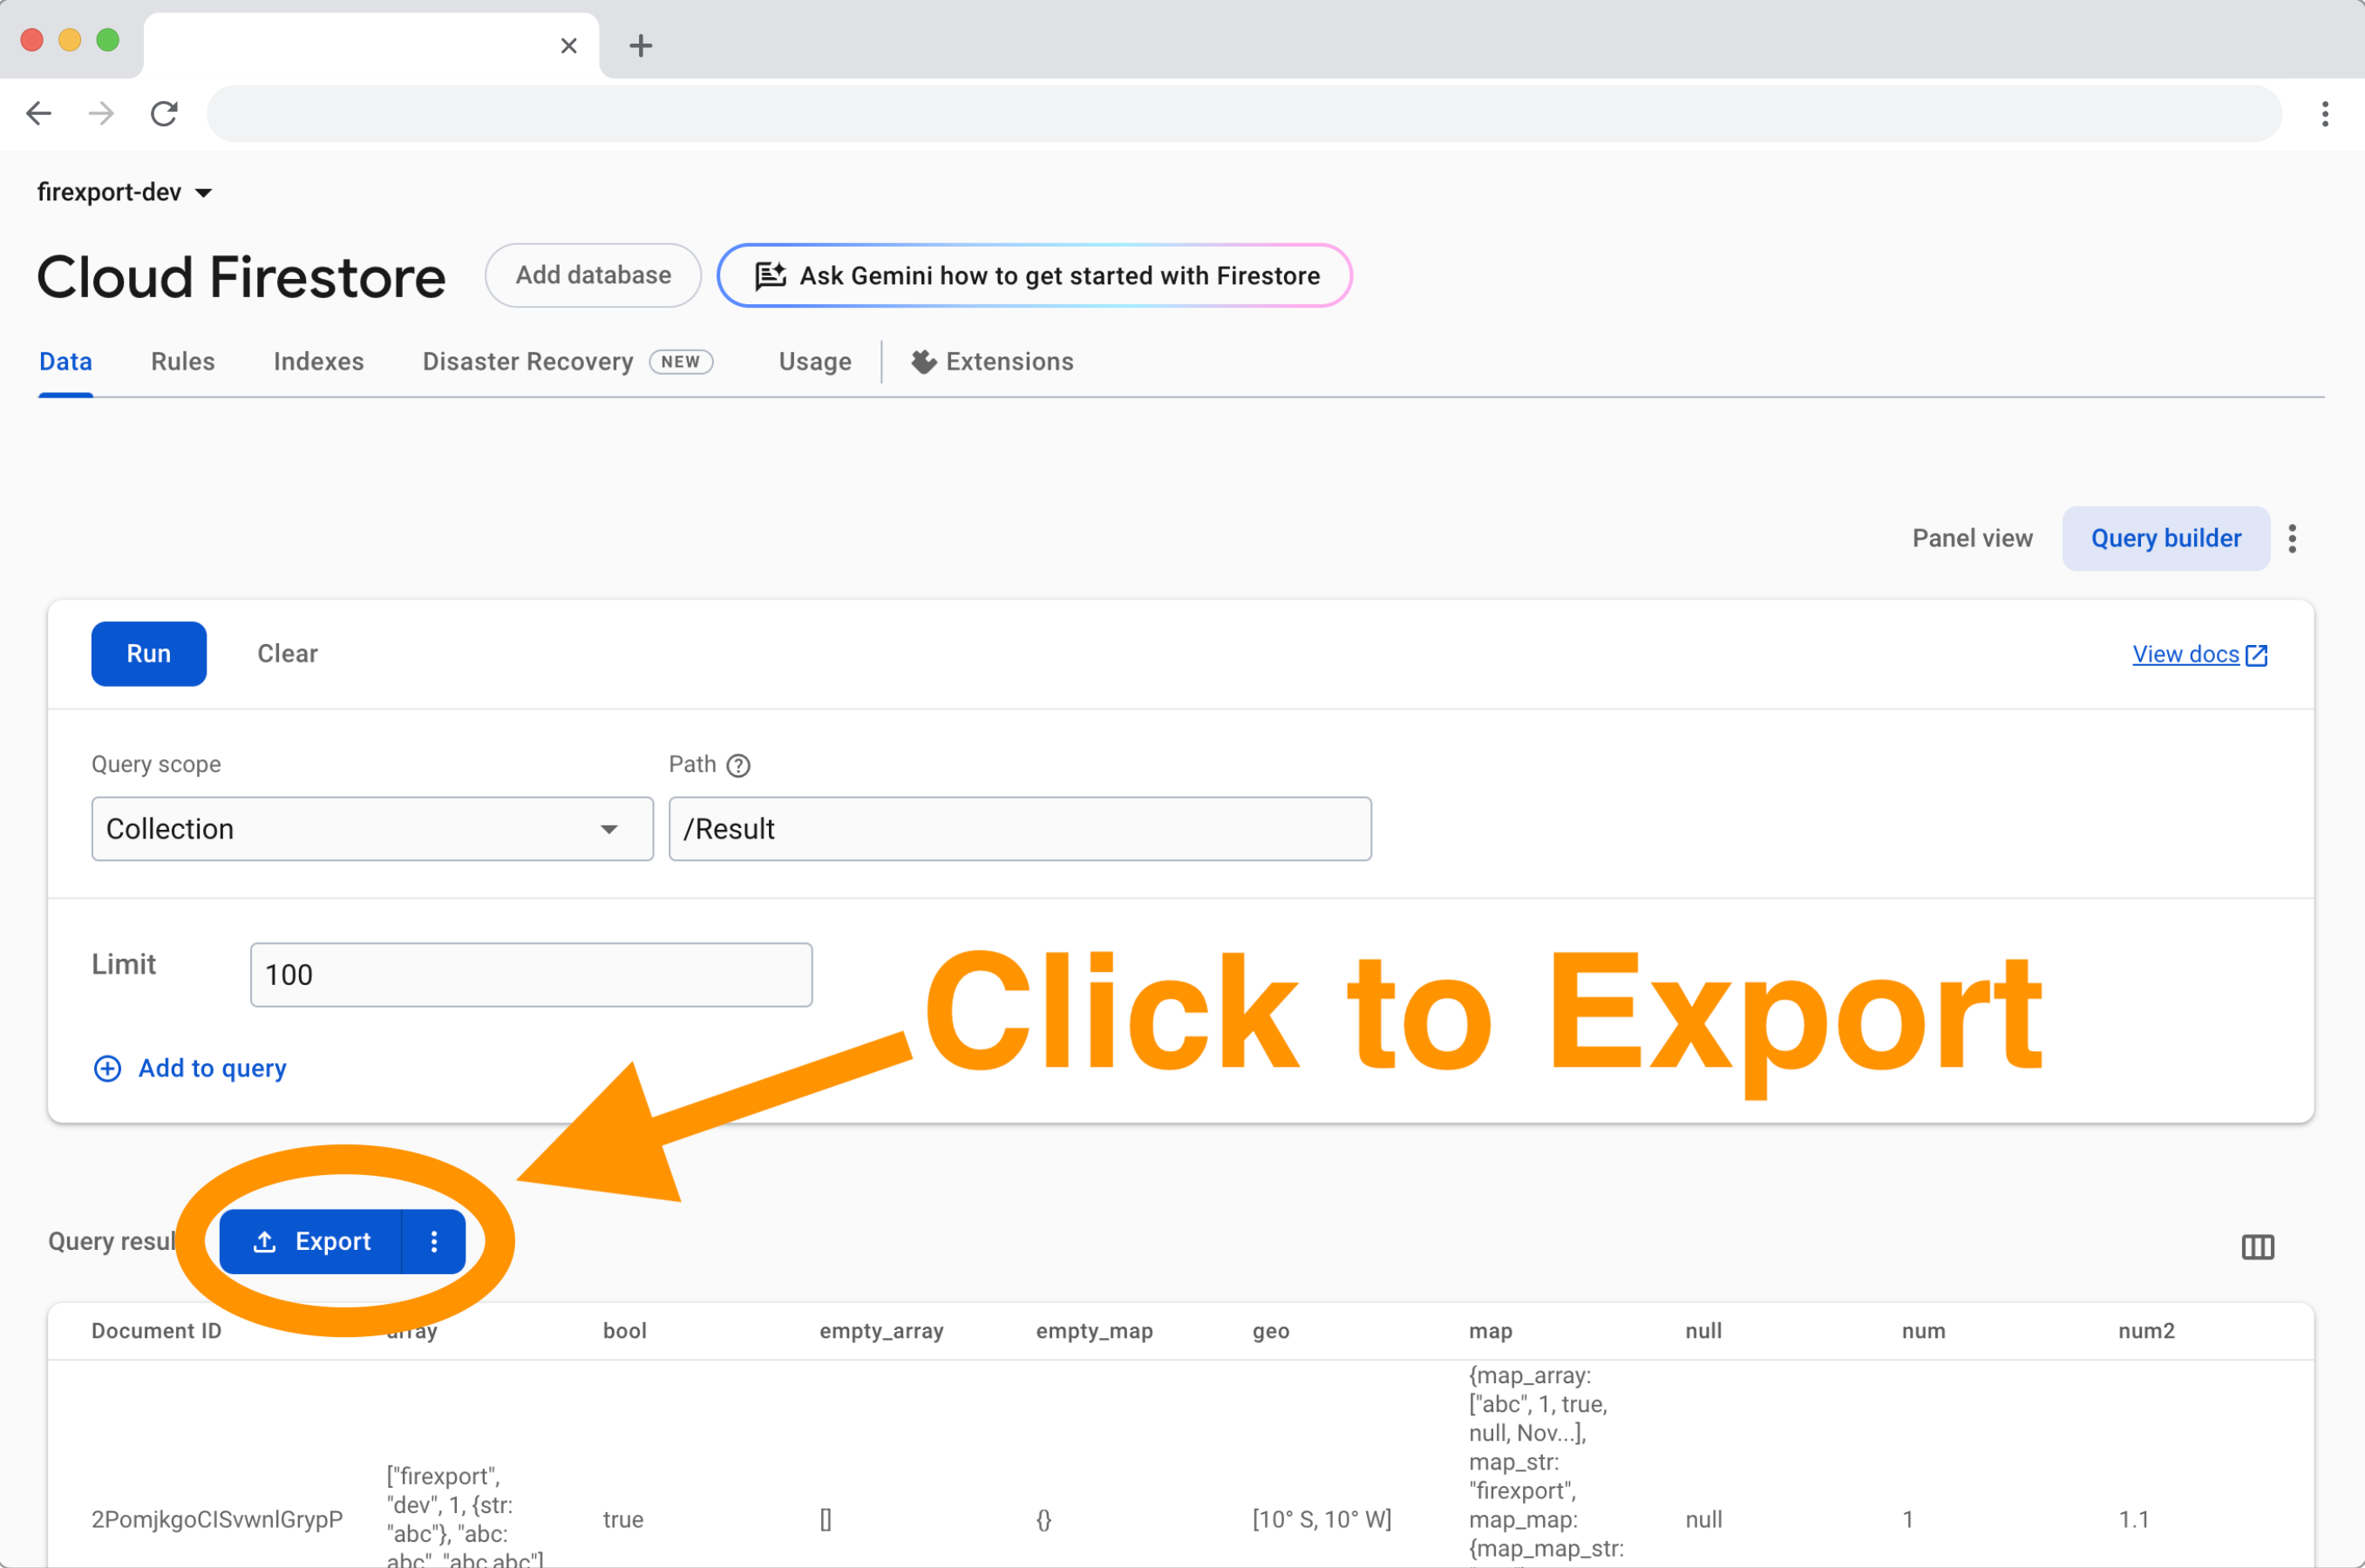
- 在 Firebase 控制台中打开 Firestore Database,从面板视图(Panel view)切换到查询构建器(Query builder)(“数据”标签页的右上角)。
- 在查询范围(Query scope)和路径(Path)下选择集合,需要的话添加过滤条件或限制, 然后点击运行(Run)。
- 点击结果上方的导出。Firexport 会遍历结果的每一页,下载一个 CSV 文件。要导出 JSON,打开按钮旁的 ⋮ 菜单并选择导出为 JSON。
文件中会包含:
- 一个文档 ID(Document ID)列,然后是每个字段一列,顺序与控制台表格一致。
- 值与控制台显示的一致。在免费版中,时间戳采用控制台的显示格式(取决于浏览器的语言和时区),引用会被缩短, 较长的映射或数组可能被“…”截断。
- Firexport Advanced(一次性许可证)会从控制台已加载的数据中还原 ISO 8601 时间戳、完整的引用路径、地理位置点以及 未截断的映射和数组。
无需服务账号密钥,也无需设置结算:它在你已登录的控制台会话中运行,文件在浏览器内生成。它一次导出一个查询, 所以子集合只有在作为集合组查询时才会一起导出。它可在 Chrome 及其他基于 Chromium 的浏览器中运行。
不用脚本、不用服务账号密钥,直接从控制台导出你的下一个 Firestore 查询。
 添加到 Chrome — 免费
2. 用 Admin SDK 脚本导出
如果你不想用扩展程序,或者导出需要按计划运行,一段使用 Firebase Admin SDK 的简短 Node.js 脚本就能搞定。它需要一个 能读取 Firestore 的账号:项目 Owner 或 Editor,或者 Cloud Datastore Viewer 角色。
- 安装 SDK:
npm install firebase-admin - 登录以获取本地凭据:
gcloud auth application-default login。在服务器上,改为让GOOGLE_APPLICATION_CREDENTIALS指向服务账号密钥。 - 把下面的脚本保存为
export-to-csv.mjs,替换your-project-id,然后运行node export-to-csv.mjs users。
// Usage: node export-to-csv.mjs users   → writes users.csv
import { writeFileSync } from 'node:fs';
import { initializeApp } from 'firebase-admin/app';
import {
  getFirestore,
  FieldPath,
  Timestamp,
  GeoPoint,
  DocumentReference,
} from 'firebase-admin/firestore';

initializeApp({ projectId: 'your-project-id' });
const db = getFirestore();
const collection = process.argv[2];
if (!collection) throw new Error('Usage: node export-to-csv.mjs <collection>');

// Read the collection 1,000 documents at a time, so large collections don't time out.
const docs = [];
let last;
while (true) {
  let query = db.collection(collection).orderBy(FieldPath.documentId()).limit(1000);
  if (last) query = query.startAfter(last);
  const page = await query.get();
  if (page.empty) break;
  docs.push(...page.docs);
  last = page.docs[page.docs.length - 1];
}

// Firestore types become plain values: timestamps as ISO 8601, references as paths.
function plain(value) {
  if (value instanceof Timestamp) return value.toDate().toISOString();
  if (value instanceof DocumentReference) return value.path;
  if (value instanceof GeoPoint) return { latitude: value.latitude, longitude: value.longitude };
  if (value instanceof Uint8Array) return Buffer.from(value).toString('base64');
  if (Array.isArray(value)) return value.map(plain);
  if (value && typeof value === 'object') {
    return Object.fromEntries(Object.entries(value).map(([key, v]) => [key, plain(v)]));
  }
  return value;
}

// Maps and arrays go in one cell as JSON. Quote any cell with a comma, a quote or a line break.
function cell(value) {
  if (value === null || value === undefined) return '';
  const text = typeof value === 'object' ? JSON.stringify(value) : String(value);
  return /[",\r\n]/.test(text) ? `"${text.replaceAll('"', '""')}"` : text;
}

const rows = docs.map((doc) => ({ documentId: doc.id, ...plain(doc.data()) }));
// Documents in one collection can have different fields, so the columns are all of them.
const columns = [...new Set(rows.flatMap((row) => Object.keys(row)))];
const lines = [columns, ...rows.map((row) => columns.map((column) => row[column]))];
writeFileSync(`${collection}.csv`, lines.map((line) => line.map(cell).join(',')).join('\r\n'));
console.log(`Wrote ${rows.length} documents to ${collection}.csv`);- 要导出所有父文档下的某个子集合,把
db.collection改为db.collectionGroup。 - 脚本在写入文件之前会把所有行放在内存中。如果有数百万个文档,请使用方法 3。
3. 用 gcloud 和 BigQuery 导出
Firestore 的托管导出会把备份以 Firestore 自己的格式写入 Cloud Storage,而不是 CSV。BigQuery 可以加载这种格式并 写出 CSV。这是大型集合的路线,但需要启用结算(Blaze 方案),以及运行导出和写入存储桶的权限。Google 的导出和导入文档列出了所需角色。
# 1. Export one collection. BigQuery only loads exports made with --collection-ids.
gcloud firestore export gs://YOUR_BUCKET/users-export --collection-ids=users

# 2. Load it into a BigQuery dataset in the same location as the bucket.
bq --location=US mk --dataset firestore_export
bq load --source_format=DATASTORE_BACKUP firestore_export.users \
  gs://YOUR_BUCKET/users-export/all_namespaces/kind_users/all_namespaces_kind_users.export_metadata
BigQuery 无法把嵌套列写入 CSV,而从 Firestore 导出加载的每个表都有一个:保存文档 ID 的 __key__。 所以先用查询做一份扁平副本,把映射和数组变成 JSON 文本,再提取它。
# 3. Make a flat copy: maps and arrays become JSON text. List your own fields.
bq query --use_legacy_sql=false --destination_table=firestore_export.users_flat \
'SELECT __key__.name AS documentId, email, createdAt,
        TO_JSON_STRING(address) AS address, TO_JSON_STRING(tags) AS tags
 FROM firestore_export.users'

# 4. Write it to CSV and download it.
bq extract --destination_format=CSV firestore_export.users_flat gs://YOUR_BUCKET/users.csv
gcloud storage cp gs://YOUR_BUCKET/users.csv .- BigQuery 每个文件最多写入 1 GB。更多数据请使用通配符,例如
gs://YOUR_BUCKET/users-*.csv。 - 导出按每个文档一次文档读取计费。完成后删除导出文件夹,以免继续占用 Cloud Storage。
常见问题
Firebase 控制台能把 Firestore 数据导出为 CSV 吗?
不能。Firebase 控制台的 Firestore 页面没有下载按钮。托管导出(Google Cloud 控制台的导入/导出页面,或 gcloud firestore export)会把 Firestore 自有格式的备份写入 Cloud Storage。它用于恢复数据,而不是在电子表格中打开。
导出 Firestore 数据要花钱吗?
每种方法都会至少读取一次每个导出的文档,Firestore 会把这些计为文档读取。在每日免费配额内不花钱。托管导出还需要项目启用结算,其文件在删除之前会一直占用 Cloud Storage。
如何导出子集合?
把它作为集合组来查询。在控制台中,在查询构建器的查询范围(Query scope)里选择集合组(Collection group)。在脚本中,用 db.collectionGroup() 代替 db.collection()。使用 gcloud 时,把子集合的 ID 传给 --collection-ids。
可以改为导出 JSON 吗?
可以。Firexport 的导出菜单中有“导出为 JSON”。脚本可以用 JSON.stringify(rows) 代替 CSV。在 BigQuery 中,bq extract --destination_format=NEWLINE_DELIMITED_JSON 会保持映射和数组的嵌套结构。